随着新零售业态的深度融合与消费者需求的多元化演变,供应链管理正经历着一场前所未有的数字化转型。在北京,这一变革的最新成果已初见端倪:全渠道库存准确率成功提升至惊人的 99.5%。这一数据的突破,不仅仅是技术指标的飞跃,更是供应链管理体系从“人力密集型”向“数据驱动型”彻底转型的里程碑。它标志着以云仓为核心的智慧物流生态,正在重塑零售行业的核心竞争力。
长期以来,库存管理一直是困扰大型零售企业的痛点。在传统的多门店、多电商平台并存的模式下,信息孤岛现象极为严重。线下门店的库存数据往往滞后于线上销售速度,导致“超卖”、“缺货”或“积压”频繁发生。这种低效不仅增加了仓储成本,更直接损害了消费者的购物体验。过去,企业依赖人工盘点和 Excel 表格进行数据修正,面对海量 SKU(库存量单位)时,误差几乎不可避免。如何在高并发交易场景下保持库存的实时一致性与精准度,曾是悬在供应链管理者头顶的达摩克利斯之剑。
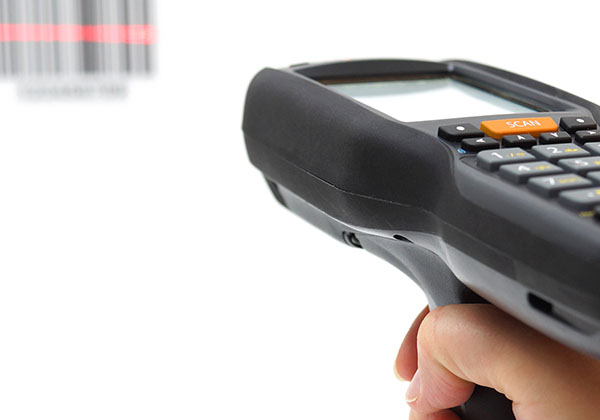
此次北京全渠道库存准确率的突破,关键在于构建了一套以云计算为底座、大数据为核心驱动的智能化供应链管理系统。这套系统打破了物理仓库与虚拟订单之间的壁垒,实现了商品流转的全链路数字化映射。通过引入先进的物联网技术,包括RFID 射频识别与智能称重传感器,每一件商品的入库、上架、调拨及出库动作都被毫秒级记录。
这些关键数据不再存储于分散的本地服务器,而是实时汇聚至云端数据中台,形成了三大核心优势:
- 实时可视化:管理者可随时查看任意节点的库存状态,消除盲区;
- 智能预警:系统能在库存异常波动前自动触发警报,防止人为疏忽;
- 自动校验:订单生成瞬间即与库存锁定匹配,杜绝超卖可能。
借助强大的数据处理能力,系统能够自动校验订单与实物的一致性,并在出现偏差前发出预警,将事后纠错转变为事前预防。更为重要的是,AI 算法深度参与了库存的动态规划过程。系统不再仅仅被动响应订单,而是基于历史销售数据、季节性趋势以及实时流量预测,主动推荐最佳的备货策略。例如,当监测到某区域线上搜索量激增时,系统会自动建议将该区域的线下门店转化为微型前置仓,就近调拨库存以缩短配送时效。这种动态调整机制,极大地优化了库存周转率,确保了资金的高效流动。对于北京这样的一线城市而言,物流半径短、订单密度高的特点,使得云仓模式的效能得到了最大程度的释放。
数据驱动带来的价值远不止于库存数字的提升。在运营层面,自动化流程减少了 90% 以上的人工干预环节,显著降低了人力成本与操作失误率。对于终端消费者而言,这意味着更高的履约确定性。无论是线上下单线下提货,还是异地发货即时达,都能获得精准可靠的到货时间承诺。这种信任感的建立,成为了品牌留存用户的关键。同时,精准的库存数据也为财务核算提供了坚实依据,消除了因账实不符导致的资产损失风险,让企业的经营决策更加从容稳健。
展望未来,供应链管理的竞争将演变为供应链生态系统的较量。99.5% 的库存准确率是一个崭新的起点,而非终点。随着技术的迭代,绿色物流、碳足迹追踪等功能将逐步融入云仓体系之中,实现经济效益与社会效益的双重统一。北京作为科技创新的高地,其供应链数字化转型的经验有望成为行业标杆,带动更多区域和企业跟进。在这场由数据引领的变革中,那些能够率先掌握核心算法、搭建敏捷网络的企业,将最终赢得市场的长期话语权。
总之,北京全渠道库存准确率达到 99.5% 的实践证明,数据已成为现代供应链中最核心的生产要素。通过云仓技术与大数据的深度耦合,我们不仅解决了效率难题,更重构了商业连接的逻辑。这不仅是物流行业的胜利,更是数字经济赋能实体经济的生动写照。未来,随着技术的进一步渗透,我们有理由相信,库存管理将更加智能、透明,为消费者创造更美好的生活体验,为企业构建更坚固的竞争护城河。